Domain africain.de kaufen?
Wir ziehen mit dem Projekt
africain.de um.
Sind Sie am Kauf der Domain
africain.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain africain.de kaufen?
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
Ähnliche Suchbegriffe für Webcrawler
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Heye Puzzle - Exotic Safari - Triangular 2000 Teile 296429Auf Rita Bermans aufregender Safari bekommt man wunderbarerweise die ganze internationale Tierwelt zu sehen! Das gibt es nur in diesem superdetailreichen Puzzle! ... 1 x Puzzle - Exotic Safari - Triangular 2000 Teile Anleitung in: Typ: Puzzle28,79 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Heye Puzzle - Wildlife Paradise, Exotic Garden - Standard 2000 Teile 291246Wie es sich für ein ordentliches Paradies gehört, leben in Maria Amalia Bartolinis exotischem Garden auf 2000 Teilen alle Tiere in schönster Harmonie ... 1 x Puzzle - Wildlife Paradise, Exotic Garden - Standard 2000 Teile Typ: Puzzle28,69 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter


-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **

Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
Top-Angebote
Produkte zum Begriff Webcrawler:
-
Philos Holz-Rahmenpuzzle - Exotic Wildlife - Wildtiere 269422Rahmenpuzzles eignen sich hervorragend für die ersten Puzzleversuche Ihres Kindes. Die Größe der 48 Holzpuzzleteile und der Rahmen erleichtern... 1x Holz-Rahmenpuzzle - Exotic Wildlife Material: Pappel und Linde Puzzleteile: 48 Stück7,68 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Heye Puzzle - Exotic Safari - Triangular 2000 Teile 296429Auf Rita Bermans aufregender Safari bekommt man wunderbarerweise die ganze internationale Tierwelt zu sehen! Das gibt es nur in diesem superdetailreichen Puzzle! ... 1 x Puzzle - Exotic Safari - Triangular 2000 Teile Anleitung in: Typ: Puzzle28,79 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Heye Puzzle - Wildlife Paradise, Exotic Garden - Standard 2000 Teile 291246Wie es sich für ein ordentliches Paradies gehört, leben in Maria Amalia Bartolinis exotischem Garden auf 2000 Teilen alle Tiere in schönster Harmonie ... 1 x Puzzle - Wildlife Paradise, Exotic Garden - Standard 2000 Teile Typ: Puzzle28,69 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Gibt es Suchmaschinen, deren Webcrawler die robots.txt ignorieren?
Ja, es gibt Suchmaschinen, deren Webcrawler die robots.txt ignorieren. Ein Beispiel dafür ist beispielsweise die Suchmaschine "Yandex". Dies kann dazu führen, dass Inhalte, die in der robots.txt-Datei als nicht zugänglich markiert sind, dennoch von diesen Suchmaschinen indexiert werden. **
-
Was ist ein Webcrawler und wie funktioniert er?
Ein Webcrawler ist ein Computerprogramm, das automatisch das Internet durchsucht, um Informationen zu sammeln. Er funktioniert, indem er eine Liste von URLs abruft, die er dann besucht und den Inhalt indexiert. Der Webcrawler folgt dabei Links auf den besuchten Seiten, um weitere Informationen zu sammeln. **
-
Wie kann ich mit Python und BeautifulSoup einen Webcrawler für Websites erstellen?
Um einen Webcrawler mit Python und BeautifulSoup zu erstellen, musst du zunächst die BeautifulSoup-Bibliothek installieren. Dann kannst du eine HTTP-Anfrage an die gewünschte Website senden und den HTML-Code der Seite mit BeautifulSoup analysieren. Du kannst dann bestimmte Elemente oder Informationen aus dem HTML-Code extrahieren und weiterverarbeiten. **
-
Wie funktionieren Webcrawler und wie werden sie zur Indexierung von Websites eingesetzt?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen. Sie sammeln Informationen über Websites und speichern sie in einer Datenbank. Diese gesammelten Informationen werden dann von Suchmaschinen verwendet, um die Websites zu indexieren und in den Suchergebnissen anzuzeigen. **
Ähnliche Suchbegriffe für Webcrawler
-
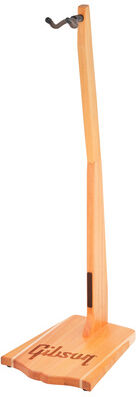
Gibson Handcrafted Wooden StandGibson Handcrafted Wooden Stand; Hochwertiger Gitarren Ständer aus Mahagoni (Swietenia Macrophylla) und Ahorn; Massivholzkonstruktion; Einfache Montage; Gewicht 7 kg; Maße (L x W x H) 25,40 x 30,50 x 106 cm; Für Gitarren mit Nitrolack geeignet; Made in USA189,00 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
LAMY safari Füllhalter 041 – Moderner Füller in der Farbe Savannah mit ergonomischem GriffDer Füller mit dem Gehäuse aus ABS-Kunststoff besticht durch sein elegantes & glänzendes Design, welches durch die schwarze Stahlfeder und den schwarzen selbstfedernden Metallclip abgerundet wird. Müheloses Schreiben durch markante Griffmulden: Dank der ergonomisch geformten Griffzone liegt der LAMY Füller sicher in der Hand - für ein angenehmes Schreibgefühl. Made in Germany - auf LAMY ist Verlass: Hohe Qualität gepaart mit einer großen Auswahl attraktiver Farben und unterschiedlicher Federbreiten fördern den individuellen Schreibstil.74,90 €*Versand: 4,90 €Sichere Weiterleitung zum Anbieter
-
Wie funktionieren Webcrawler und welche Rolle spielen sie beim Indizieren von Websites?
Webcrawler sind Programme, die das Internet nach Inhalten durchsuchen, indem sie Links auf Websites folgen und deren Inhalte indexieren. Sie scannen Websites nach relevanten Keywords und Meta-Tags, um sie in Suchmaschinen-Datenbanken zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Websites für bestimmte Suchanfragen zu finden und anzuzeigen. **
-
Welche Faktoren beeinflussen die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können?
Die Geschwindigkeit, mit der Webcrawler eine Website durchsuchen können, wird von der Serverleistung der Website, der Größe der Website und der Anzahl der Links auf der Website beeinflusst. Außerdem spielen die Netzwerkgeschwindigkeit und die Einstellungen des Webcrawlers eine Rolle bei der Durchsuchungsgeschwindigkeit. Eine gut optimierte Website mit schnellem Server und wenigen Links kann die Geschwindigkeit der Webcrawler erhöhen. **
-
Wie funktionieren Webcrawler und welche Rolle spielen sie bei der Indexierung von Webinhalten?
Webcrawler sind Programme, die automatisch das Internet durchsuchen und Webseiten indexieren. Sie folgen Links von einer Seite zur nächsten, um relevante Informationen zu sammeln. Dadurch helfen sie Suchmaschinen, Webinhalte zu finden und zu organisieren, um sie den Nutzern bei Suchanfragen präsentieren zu können. **
-
Wie funktionieren Webcrawler und was ist ihre Rolle bei der Indexierung von Websites?
Webcrawler sind Programme, die automatisch das Internet durchsuchen, indem sie Links auf Websites verfolgen und deren Inhalte analysieren. Sie sammeln Informationen über Webseiten, wie Texte, Bilder und Links, um sie in Suchmaschinenindexen zu speichern. Dadurch ermöglichen sie Suchmaschinen, relevante Suchergebnisse für Benutzer bereitzustellen. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.